从“AI渗透”到“AI攻防”:第三届智能攻防挑战赛的进阶与变局
2026年10月30日,第三届智能攻防挑战赛暨TSecCon腾讯安全大会在深圳举行,由腾讯安全云鼎实验室与腾讯云安全主办。
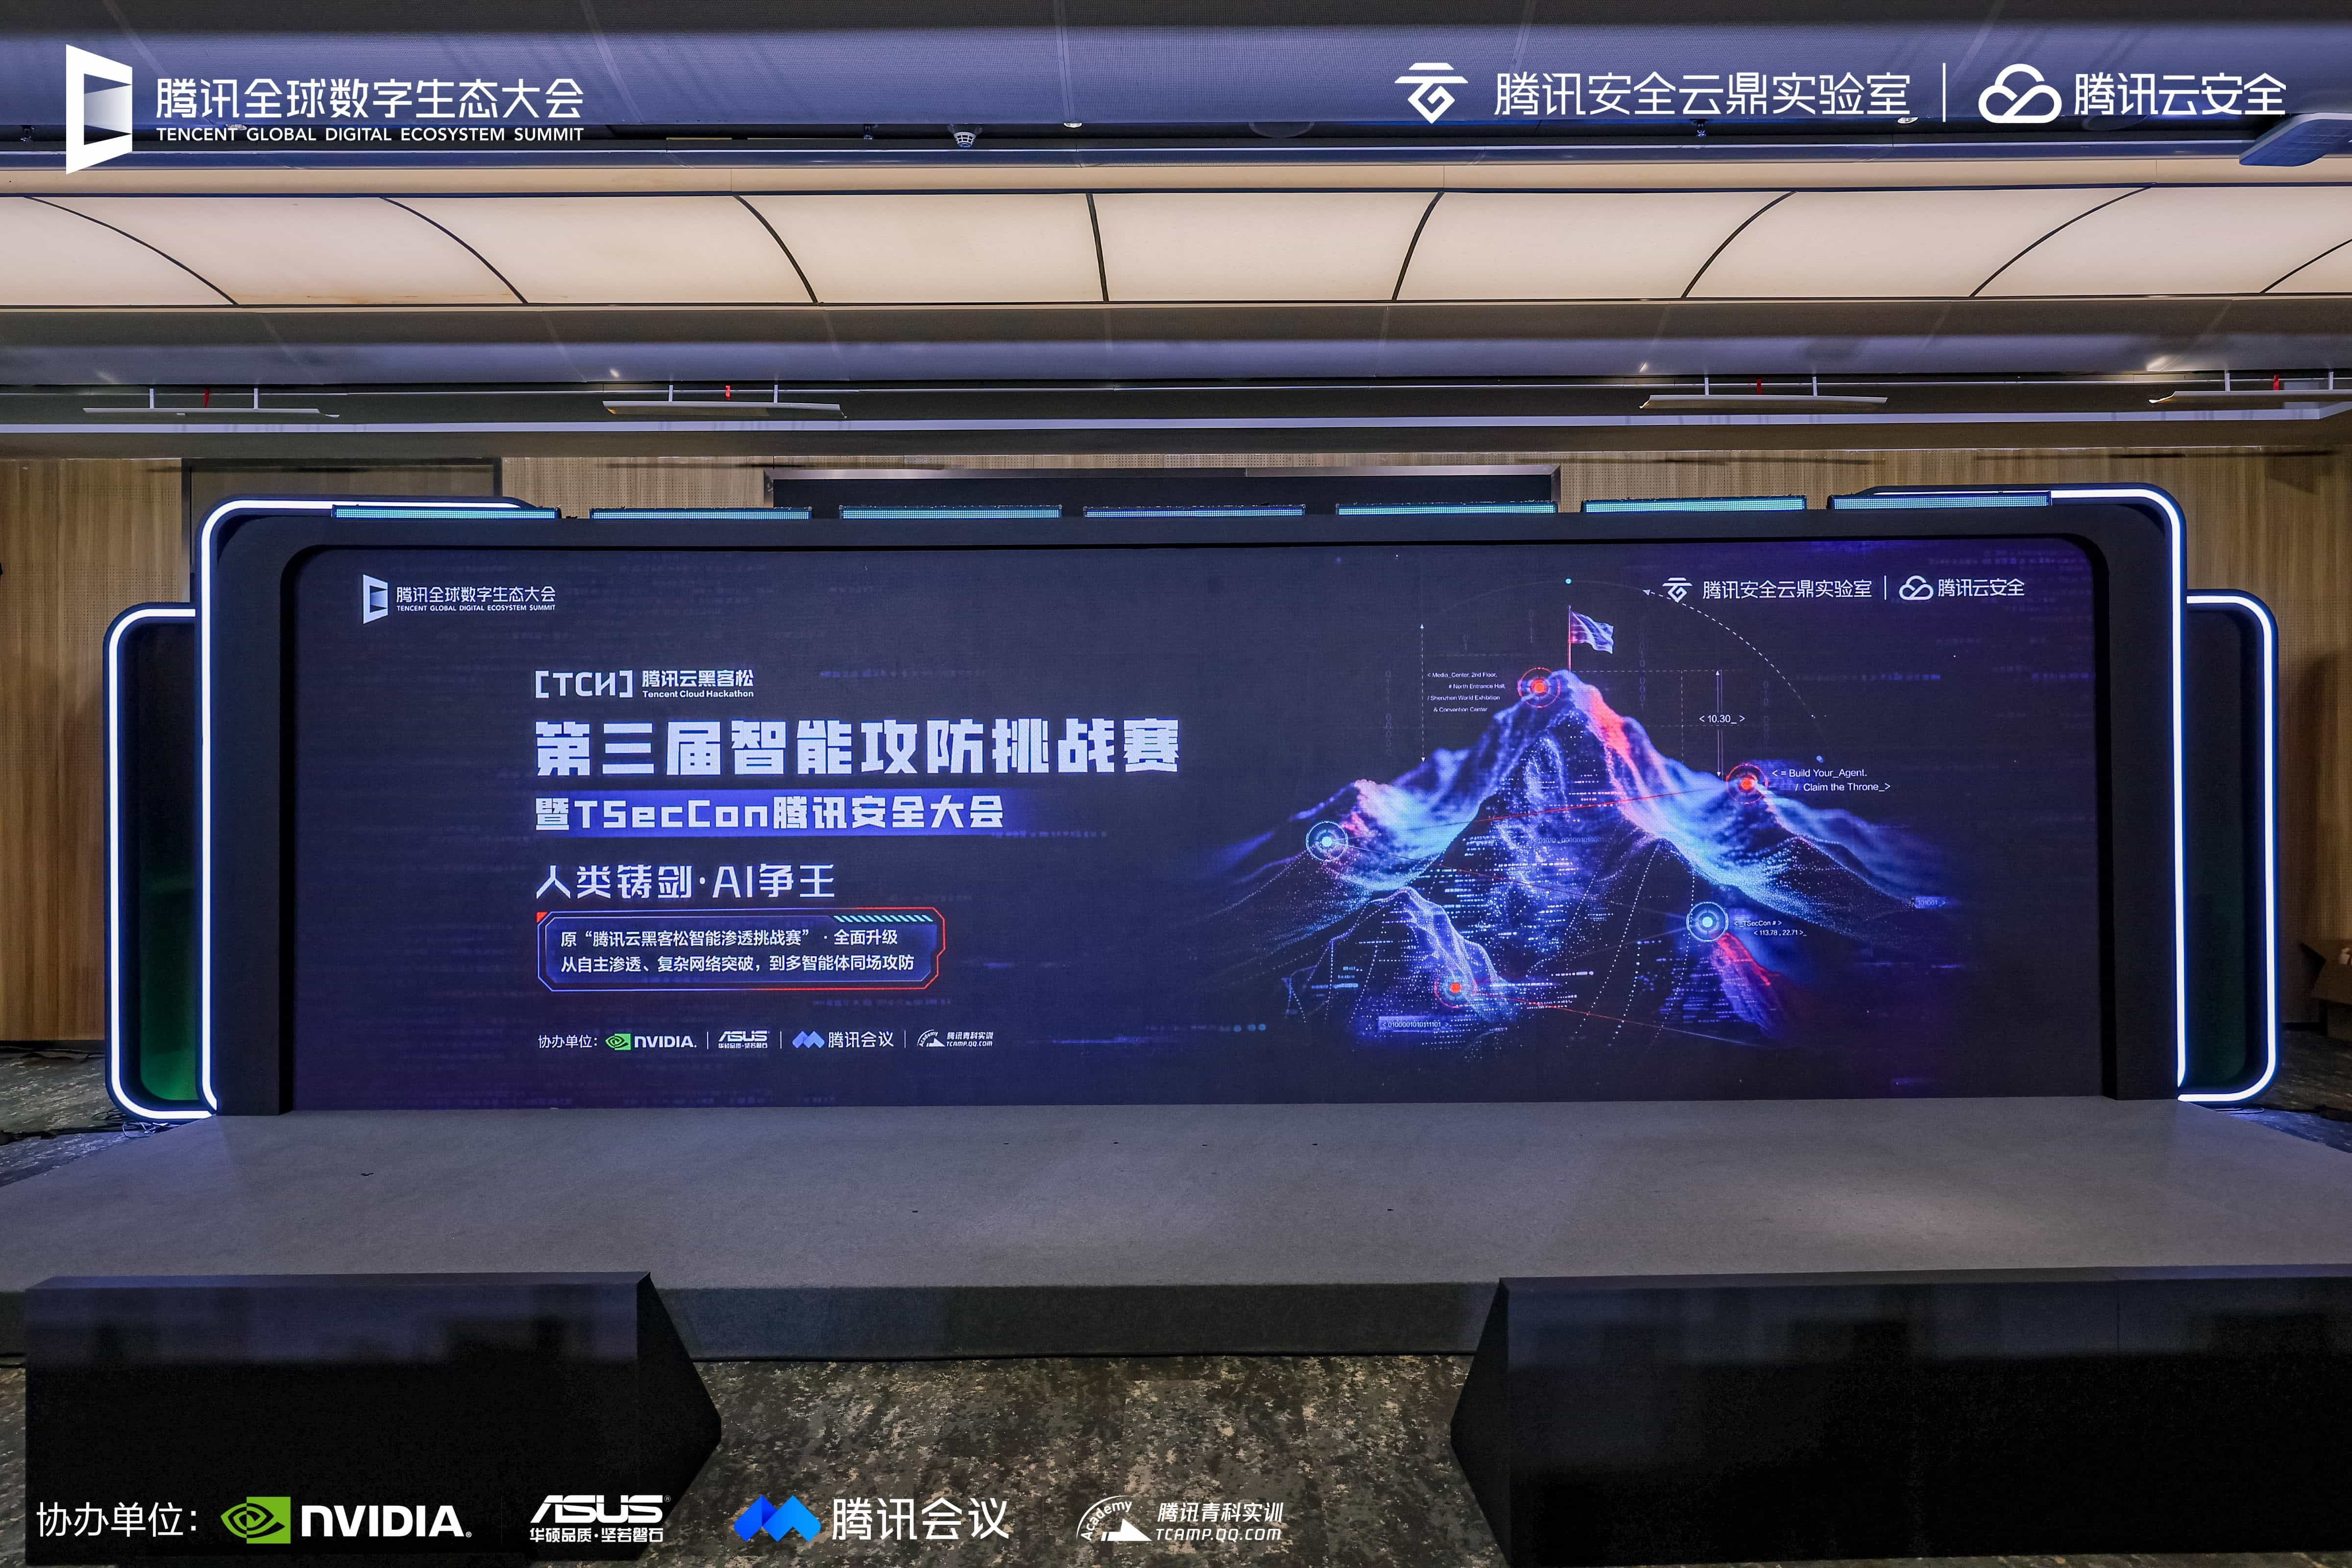
“人类铸剑,AI争王”是本届大赛的主题。所谓“人类铸剑”,是把安全研究者的经验、判断与创造力写进智能体;“AI争王”,则是让这些能力真正走进赛场,在实际任务和动态对抗中接受检验。
当AI开始自主分析、调用工具、推进任务,我们关心的问题也更加具体:它能完成什么?遇到困难能否调整策略?在有限算力和明确授权范围内,又能走多远?围绕这些问题,本届比赛设置了三项挑战:“王座协议”主赛聚焦AI智能体同场攻防;安全智子挑战赛检验本地模型的离线自主渗透能力;智能漏洞挖掘挑战赛则面向授权真实业务场景,探索AI发现和验证漏洞的实际价值。
三届进阶:从能力验证到产业实战,一份报告勾勒行业坐标
对熟悉这条赛线的人来说,本届最大的变化,不只是规模,而是命题本身。
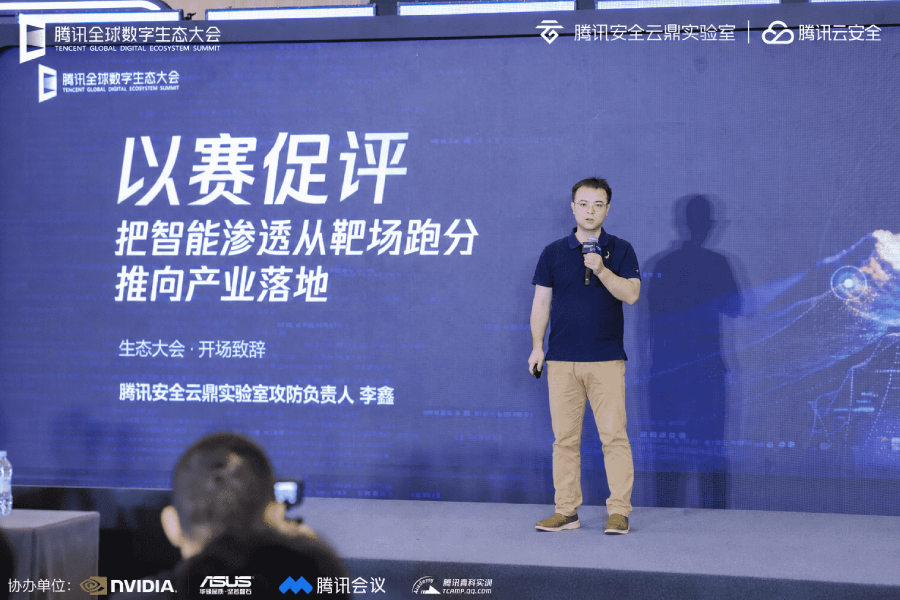
赛事前身为“腾讯云黑客松智能渗透挑战赛”,第三届全面升级为智能攻防挑战赛。腾讯安全云鼎实验室攻防负责人李鑫把三届赛事的演进概括为“以赛促评”把智能渗透从靶场跑分推向产业落地。第一届验证AI有没有自主能力;第二届将战场推进到内网、域控、社交平台及Prompt注入等复杂网络;到了第三届,本地离线算力、智能体同场攻防和真实业务漏洞挖掘开始进入赛场。
三届赛事累计吸引1500余支战队、3000余名选手参与,奖金总额达到120万元。在为期两周的实网漏洞挖掘中,参赛者提交了400多个漏洞,其中既有此前未被人工发现的问题,也出现了新的发现手法;与此同时,大量模型幻觉生成的低质量报告也开始涌入。能力提升与噪音增加,几乎同时发生。
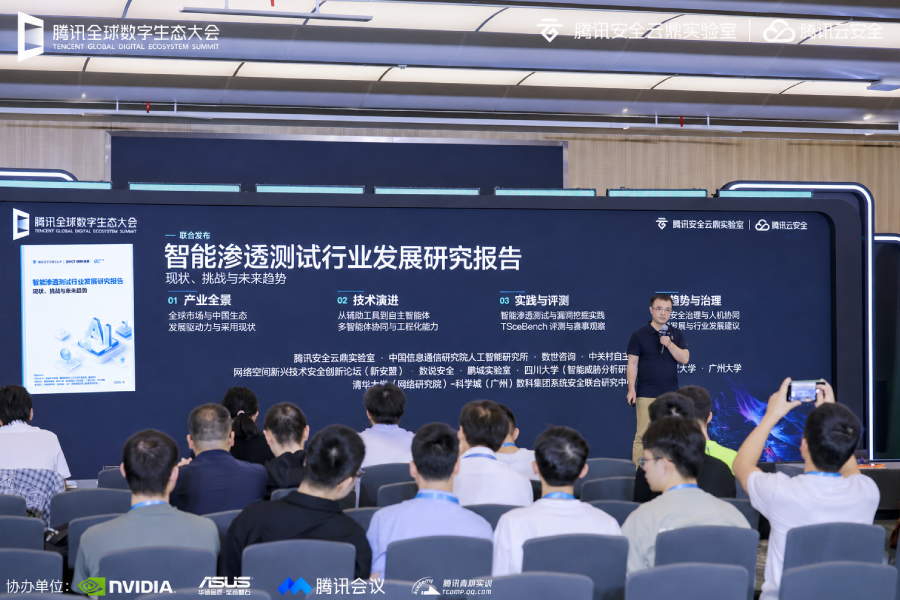
与赛事同期预发布的《智能渗透测试行业发展研究报告》,由腾讯安全云鼎实验室、中国信息通信研究院人工智能研究所、数世咨询等联合推出,则从能力评测、产业实践等角度,对这一领域的发展现状作了梳理。报告将“智能攻击测试”定义为:以大语言模型与智能体为核心驱动,自动化开展渗透测试、漏洞挖掘与攻击链编排的攻防实践。其变化不只是工具升级,而是执行主体和交付模式的转变。
赛事走到第三届,问题也随之变化——从验证“AI能不能攻击”,开始走向“AI怎样更稳定、更自主地完成真实任务”。
14场分享,四条主线:智能攻防走向工程化与实战化
大赛邀请了14位嘉宾作主题分享,从模型能力、智能体编排,到本地算力、漏洞挖掘与真实业务实践,议题覆盖多个层面。透过这些分享也可以看到,智能攻防的竞争正在从单纯比拼“模型有多强”,转向比拼能力如何释放、任务如何组织、算力如何承载,以及最终能否进入真实业务。
模型层:能力释放与安全边界重新拉扯
独立安全研究员sn1waR在两台桌面级DGX Spark上,对多个开源模型的安全护栏进行调整,并接入本地Agent开展黑白盒演练。部分模型在放宽限制后,对安全类任务的响应能力明显提升,但也有模型在解除限制后任务得分反而下降。
这说明,在安全研究场景里,“能力释放”并不等于简单去掉限制。模型能够放开到什么程度、怎样保持能力与可控性的平衡,正在成为本地化部署必须面对的问题。
执行系统层:从“模型会做”到“系统做成”
多场演讲把重点放在任务编排、状态管理、记忆和探索策略上。
四川大学王彦的评测显示,一个相对简单的ReAct基线,在部分任务上甚至能够超过多个复杂渗透框架;孙汉林则把Agent常见的探索失衡概括为“以偏概全”和“兔子洞”——一旦早期判断出错,模型可能沿错误方向持续消耗资源。
问题的关键,越来越不是“用了哪个模型”,而是怎样组织模型、工具、状态和任务。智能攻防正在从“找一个更强的模型”,走向“搭一套更可靠的系统”。
算力层:把模型装进隔离网
如果不能调用云端模型,Agent还能不能跑起来?这也是本届安全智子挑战赛重点检验的能力。
围绕本地部署,多位嘉宾展示了桌面级算力承载大模型和Agent的可行性。陈科把实际需求概括得很直接:设备既要“能装进行李箱”,也要“能过隔离墙”。
对于电力、金融、政企等数据难以出网的场景,这种变化的意义不只是算得更快,而是让Agent有机会真正进入隔离网络和本地业务环境。
实战层:真实业务开始检验AI攻击能力
不过,模型能跑、系统能用,并不意味着它已经能直接进入真实业务。郑嘉翀谈到,靶场关注的是如何拿下目标,真实业务却必须同时考虑授权范围、业务影响和时间成本。几场漏洞研究分享则进一步展示了AI进入真实漏洞发现和验证环节的可能性:从HTTP/3协议漏洞,到一个长期存在的问题最终在AI辅助下被串联成完整漏洞链,AI正在把能力带出靶场。
但进入真实业务之后,授权、验证、误报和后续处置的重要性也随之被放大。
把14场分享放在一起看,一个变化已经很明显:大家讨论的重点,已经不再只是模型本身。智能攻防正在从证明“AI能不能做”,进入“怎样把它做成、做稳,并真正放进业务里”的阶段。
双榜揭晓:一云一端,两条AI攻防路线
颁奖环节,现场公布了“王座协议”主赛场和安全智子专项挑战赛的比赛结果。
“王座协议”主赛场线下决赛共有12支战队,以AI智能体同场攻防为主要形式;安全智子专项挑战赛共有8支队伍,在不调用云端大模型的条件下,使用本地模型和本地算力完成离线自主渗透任务。
第三届智能攻防挑战赛现场结果如下:
一等奖获奖战队
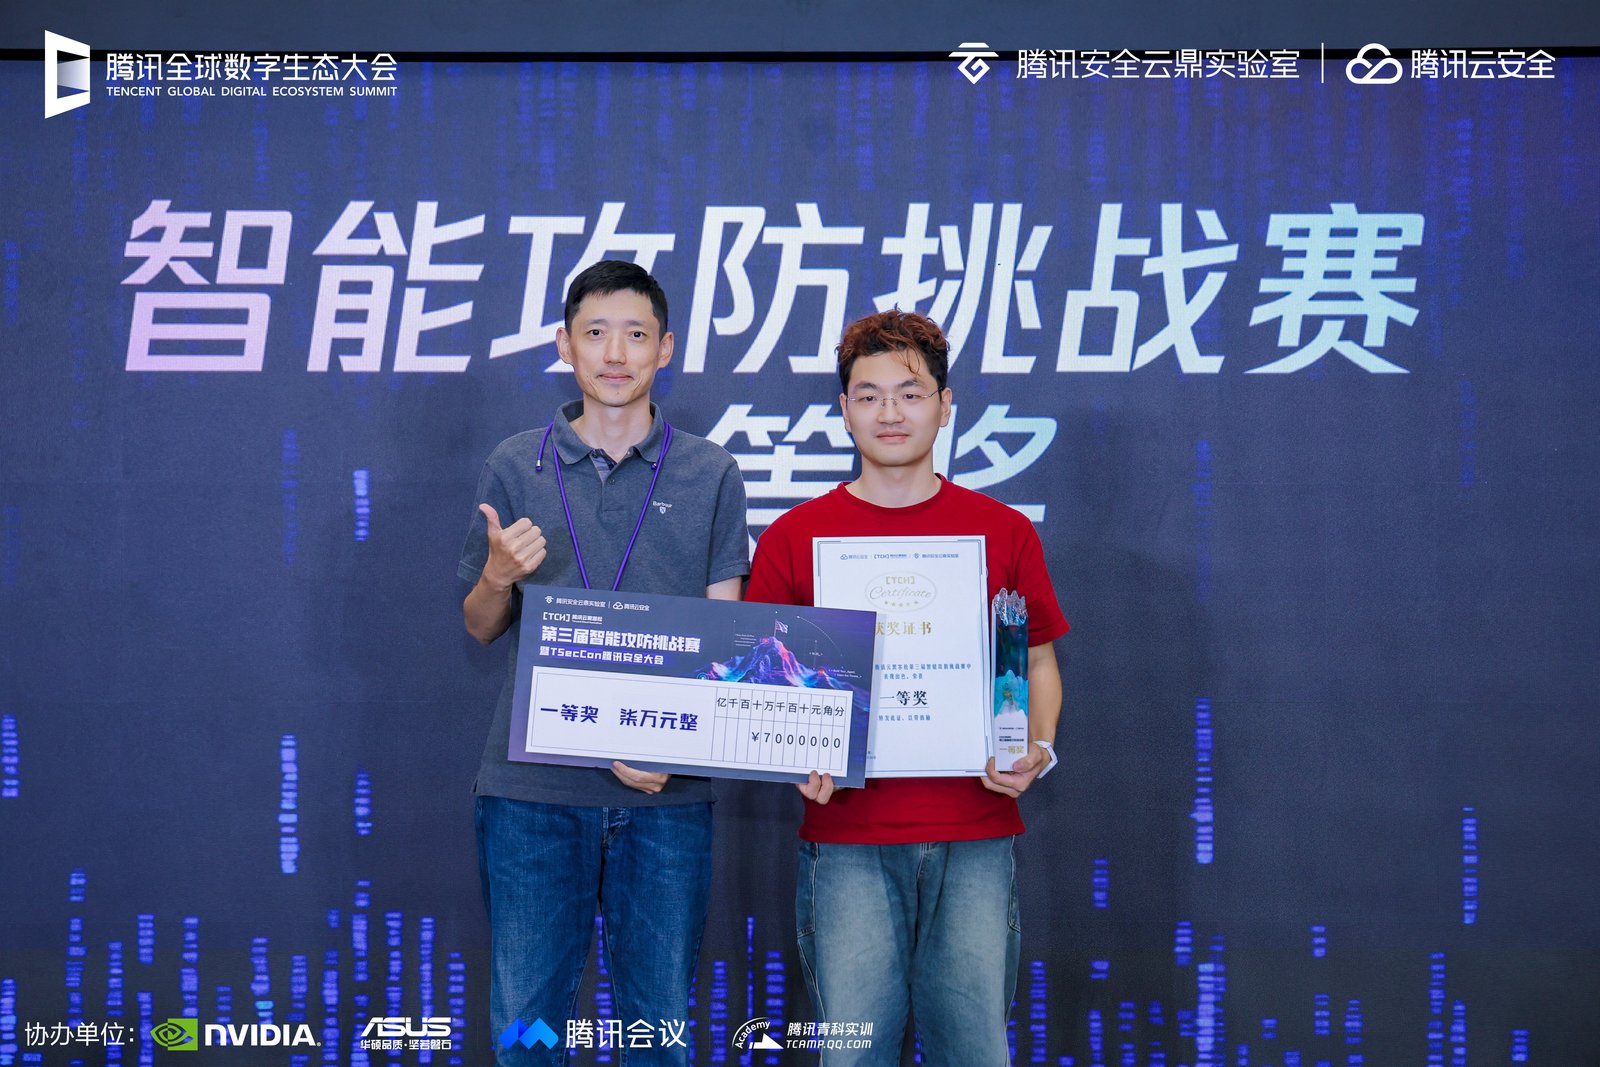
二等奖获奖战队
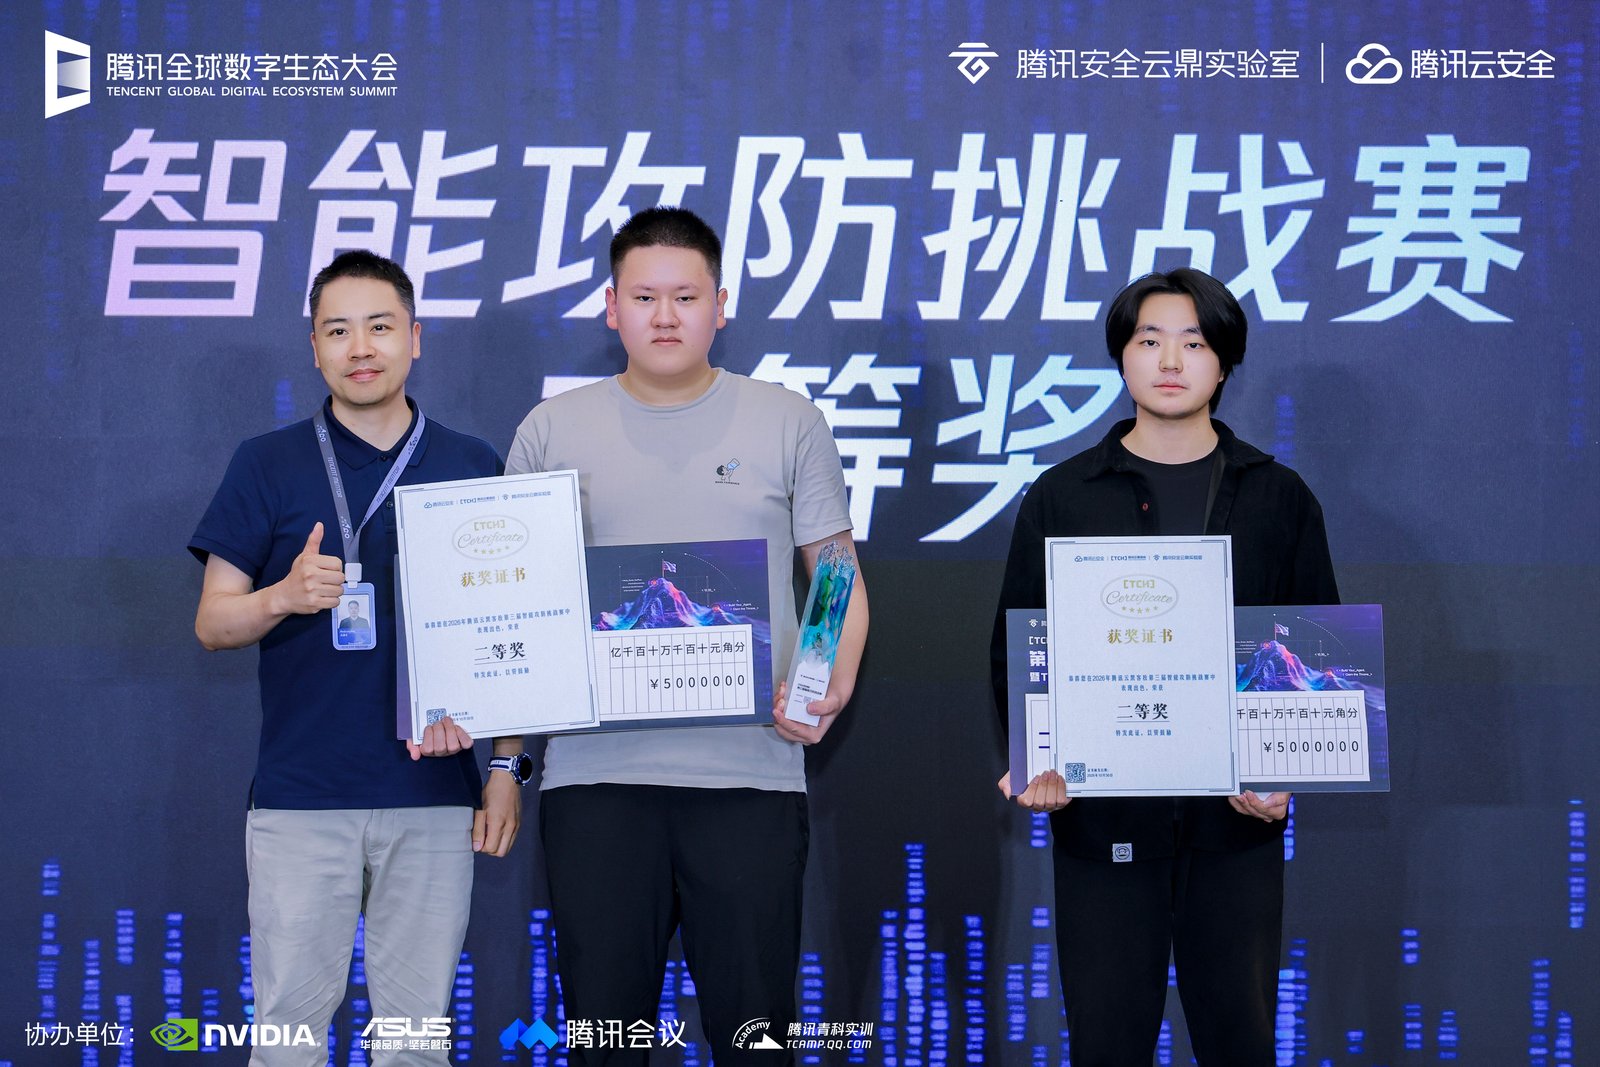
三等奖获奖战队
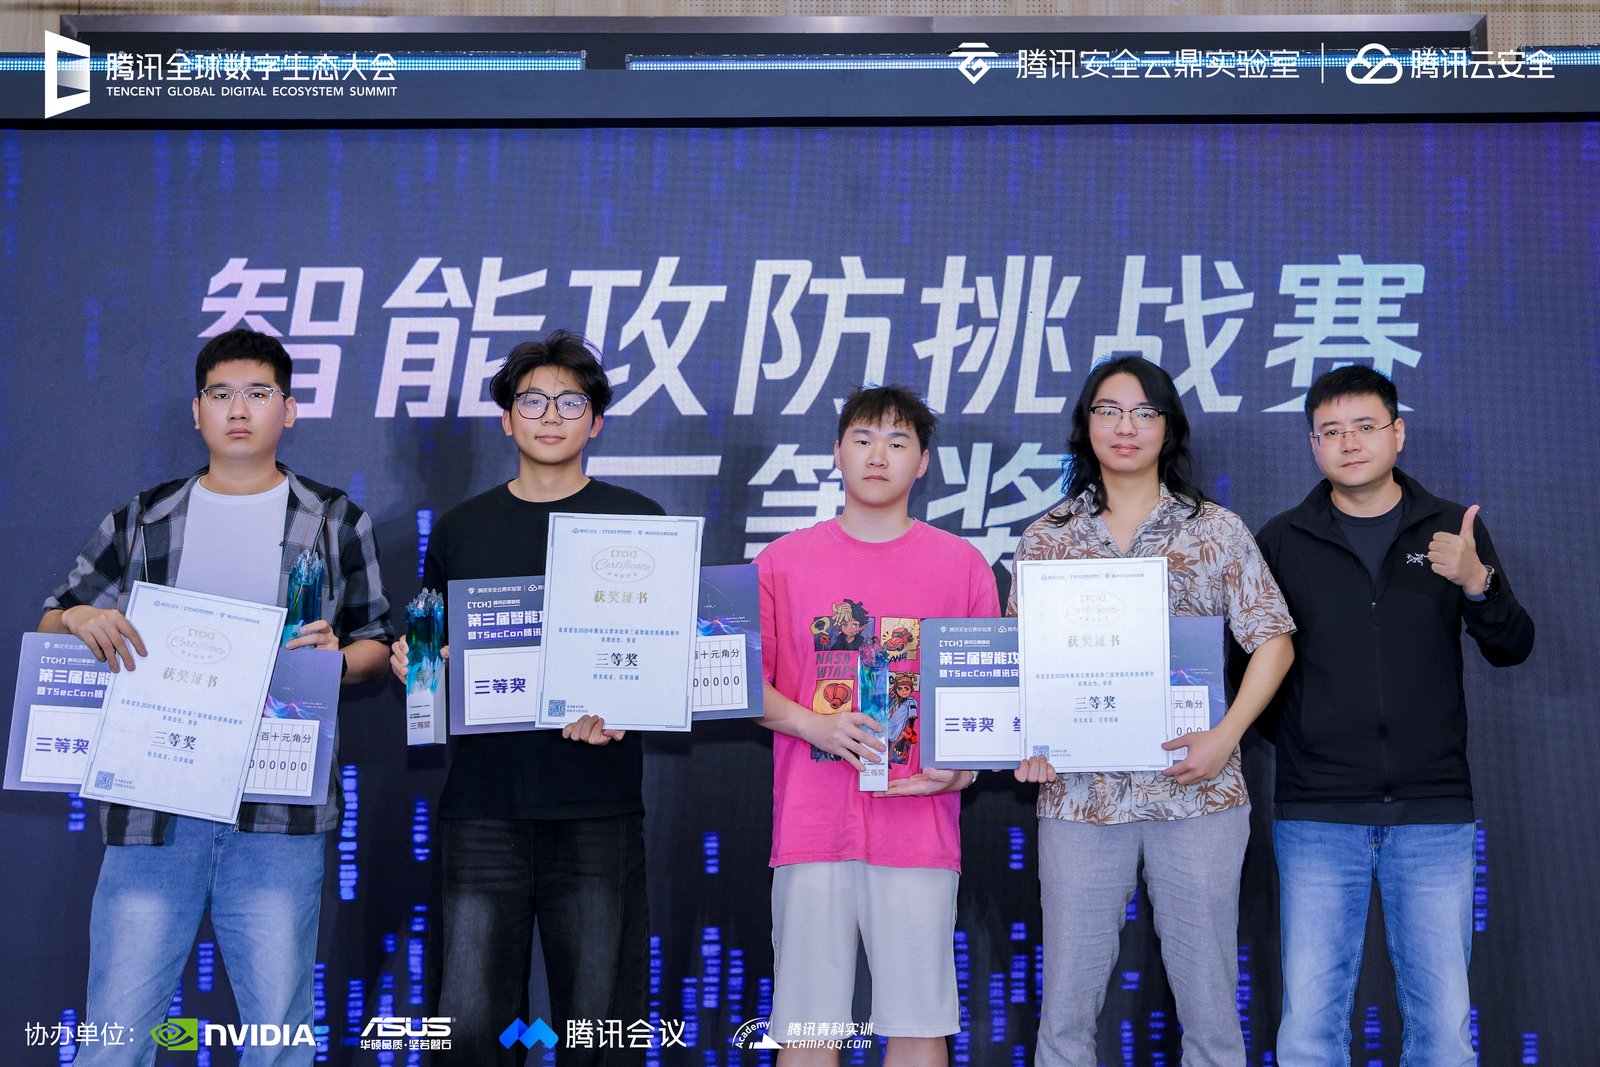
优秀奖获奖战队
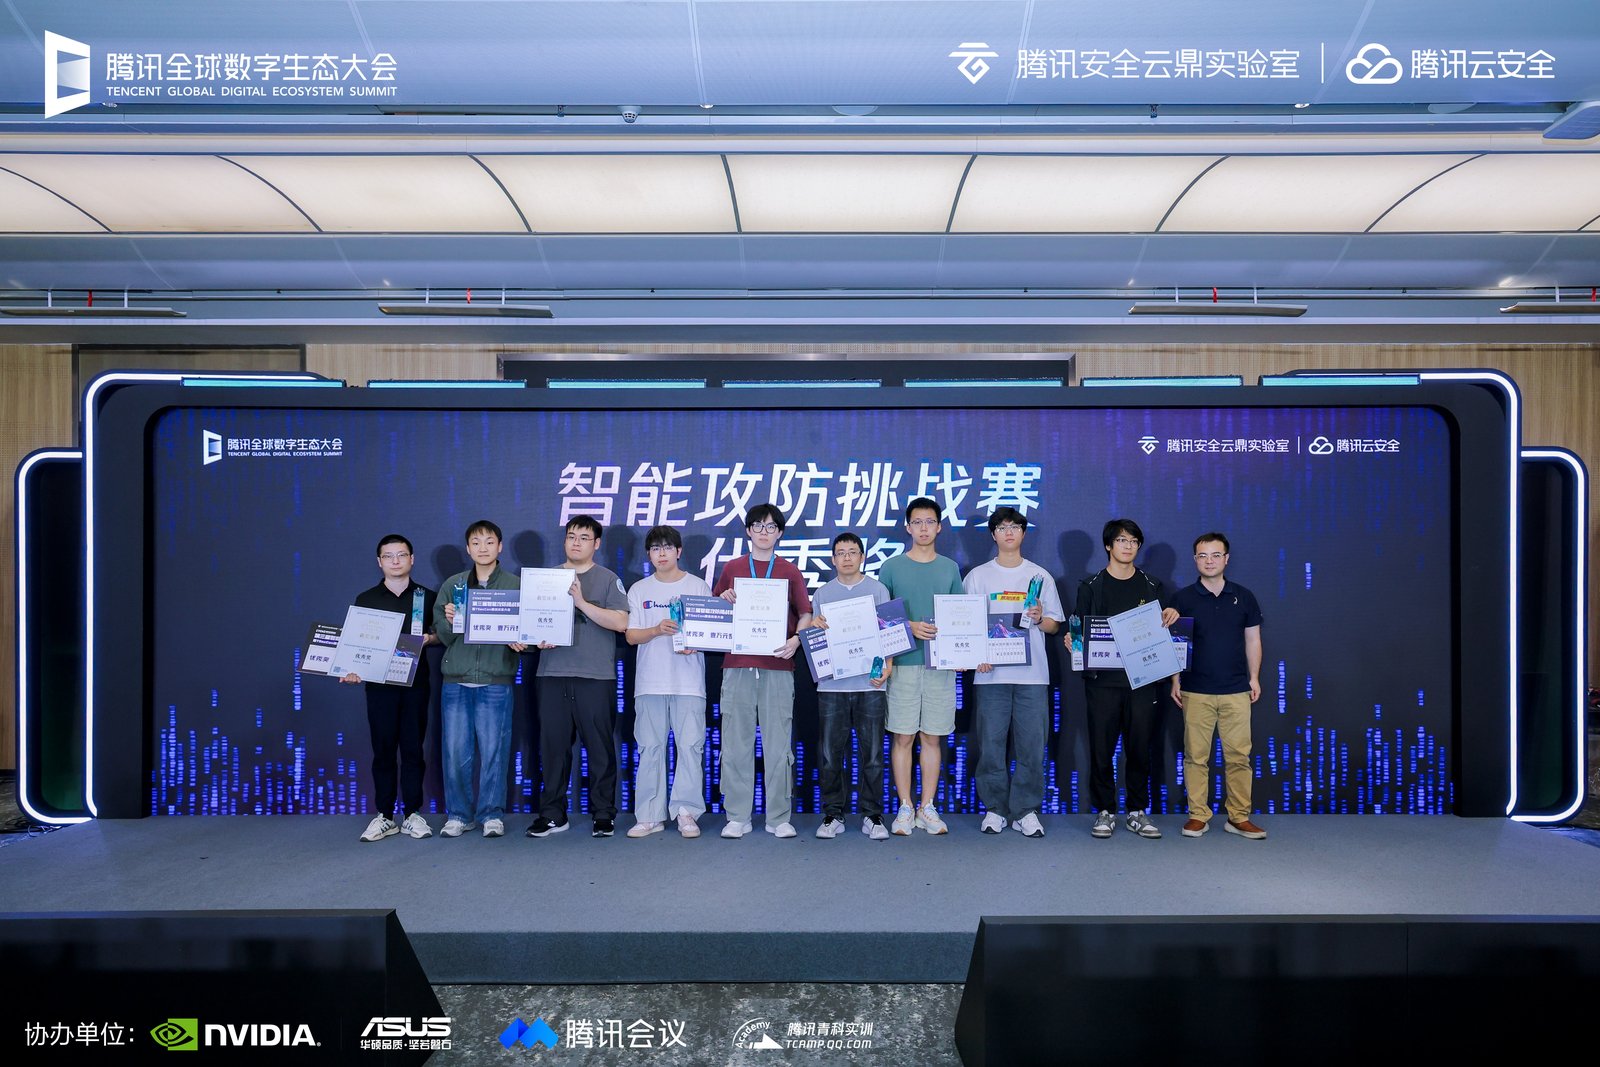
左右滑动查看
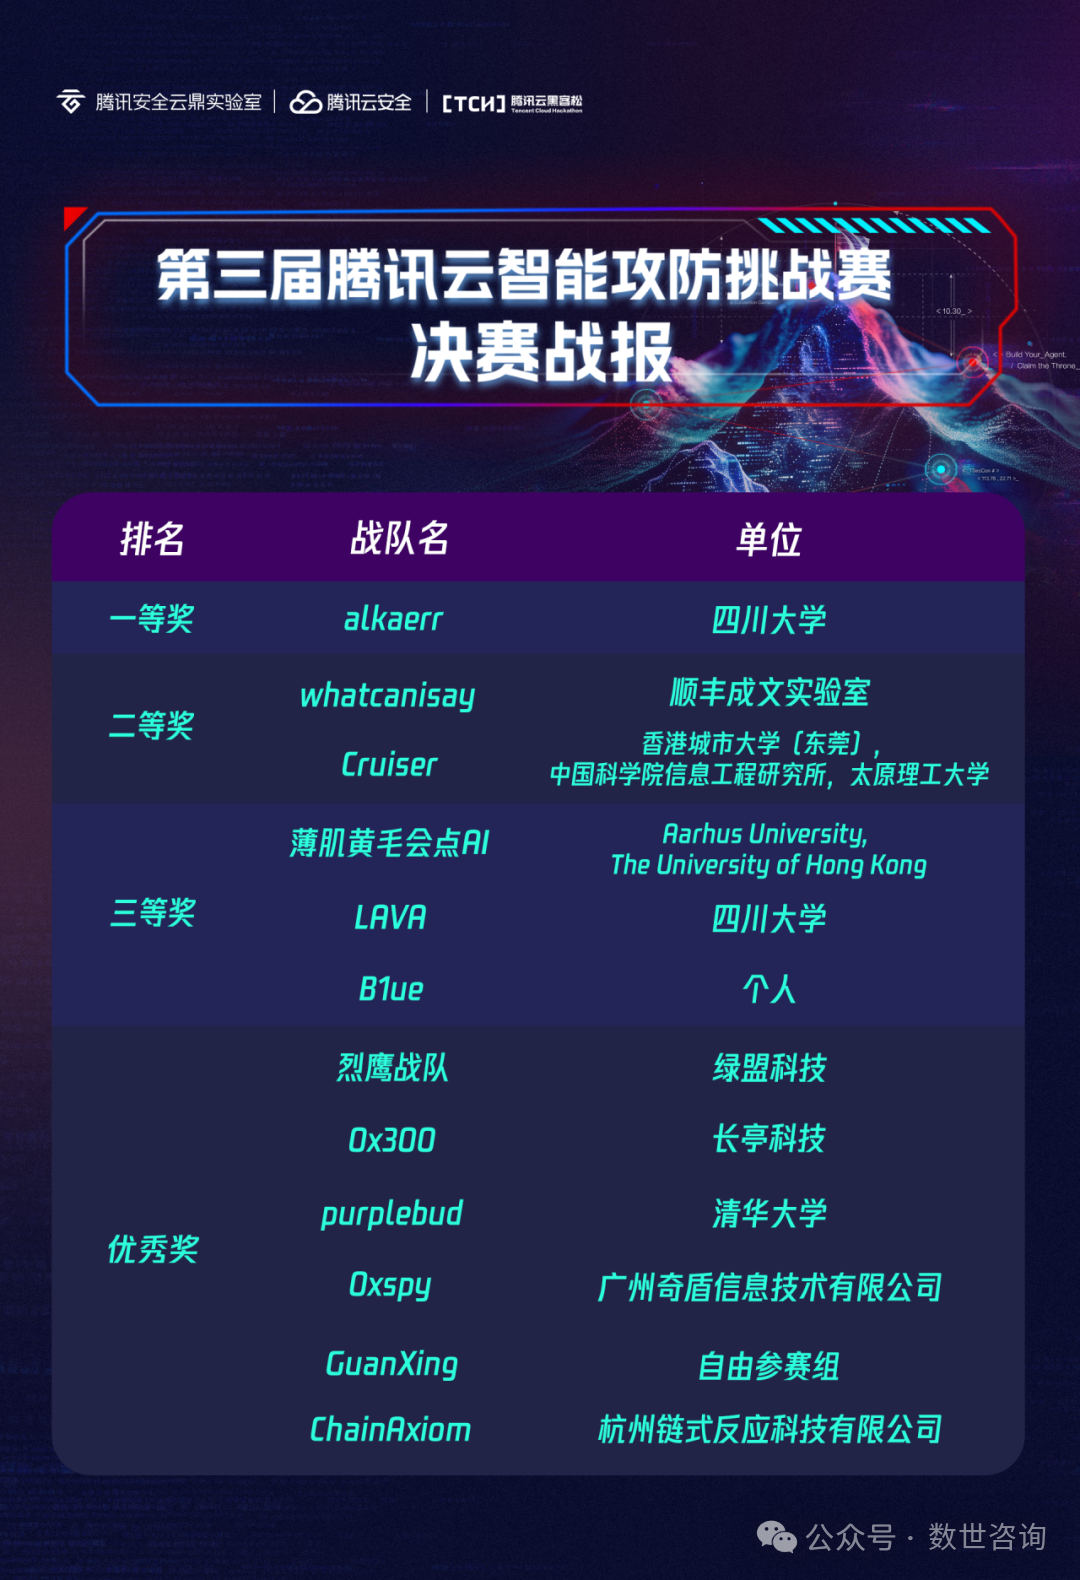
智能攻防挑战赛决赛最终排名
安全智子挑战赛现场结果如下:
一等奖获奖战队
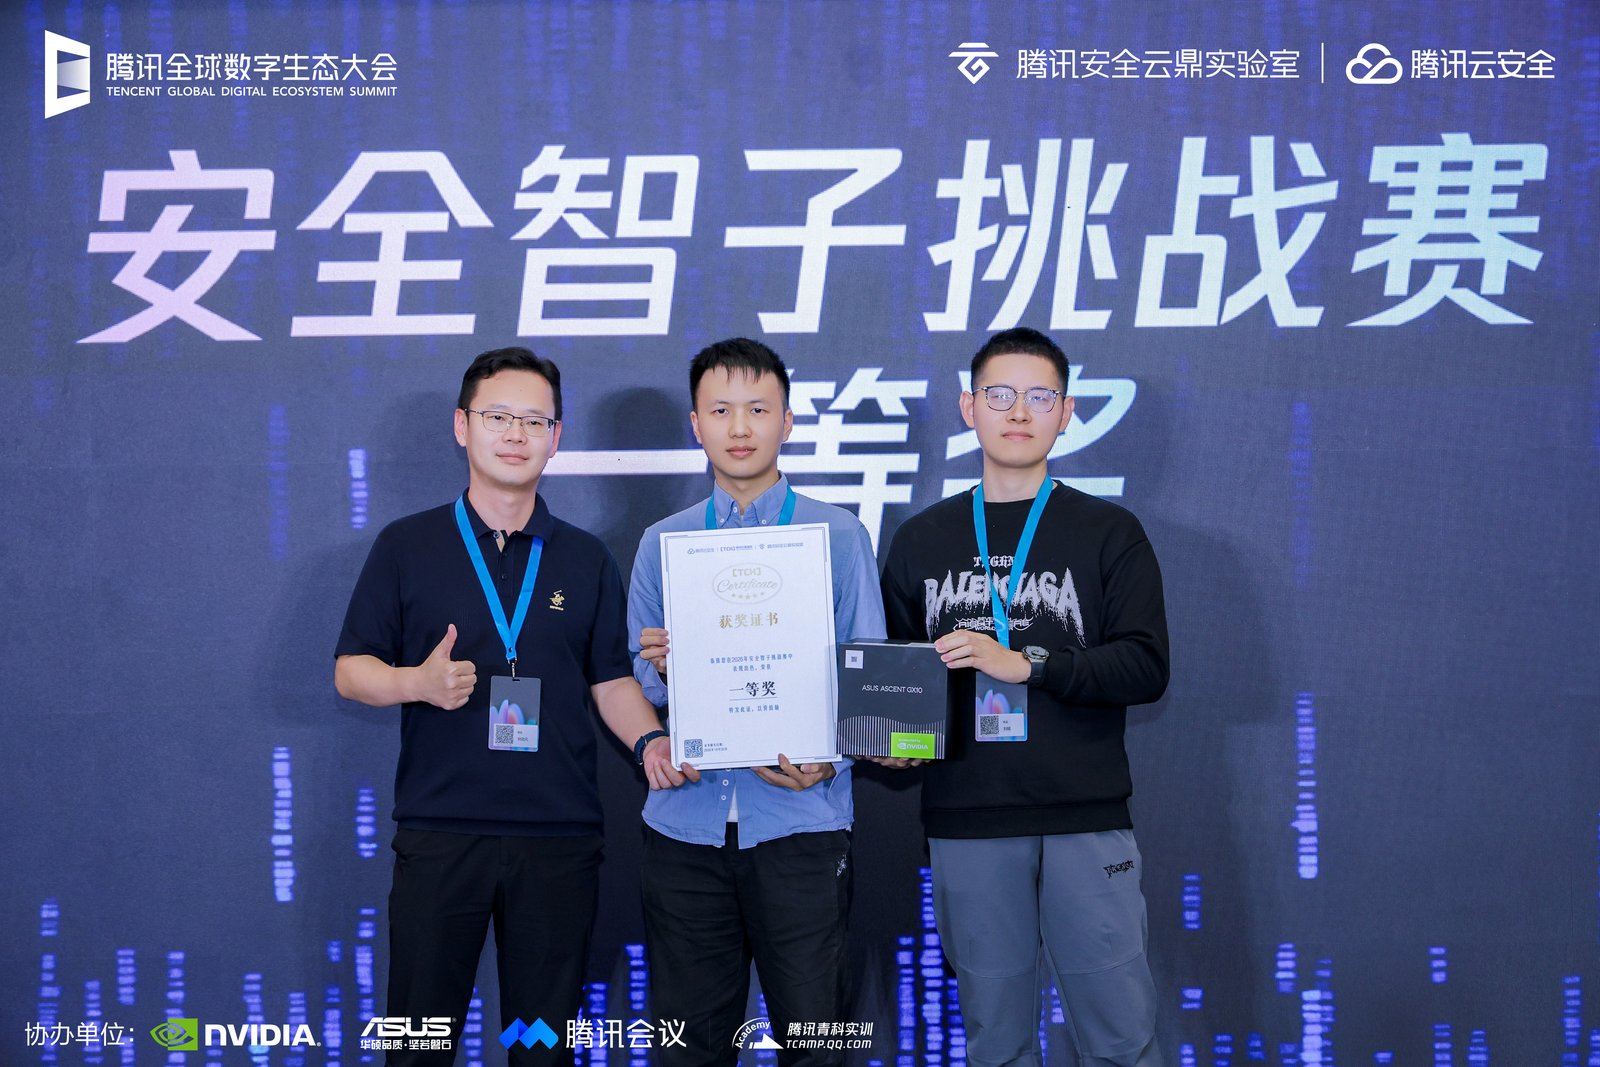
二等奖获奖战队
三等奖获奖战队
优秀奖获奖战队
左右滑动查看
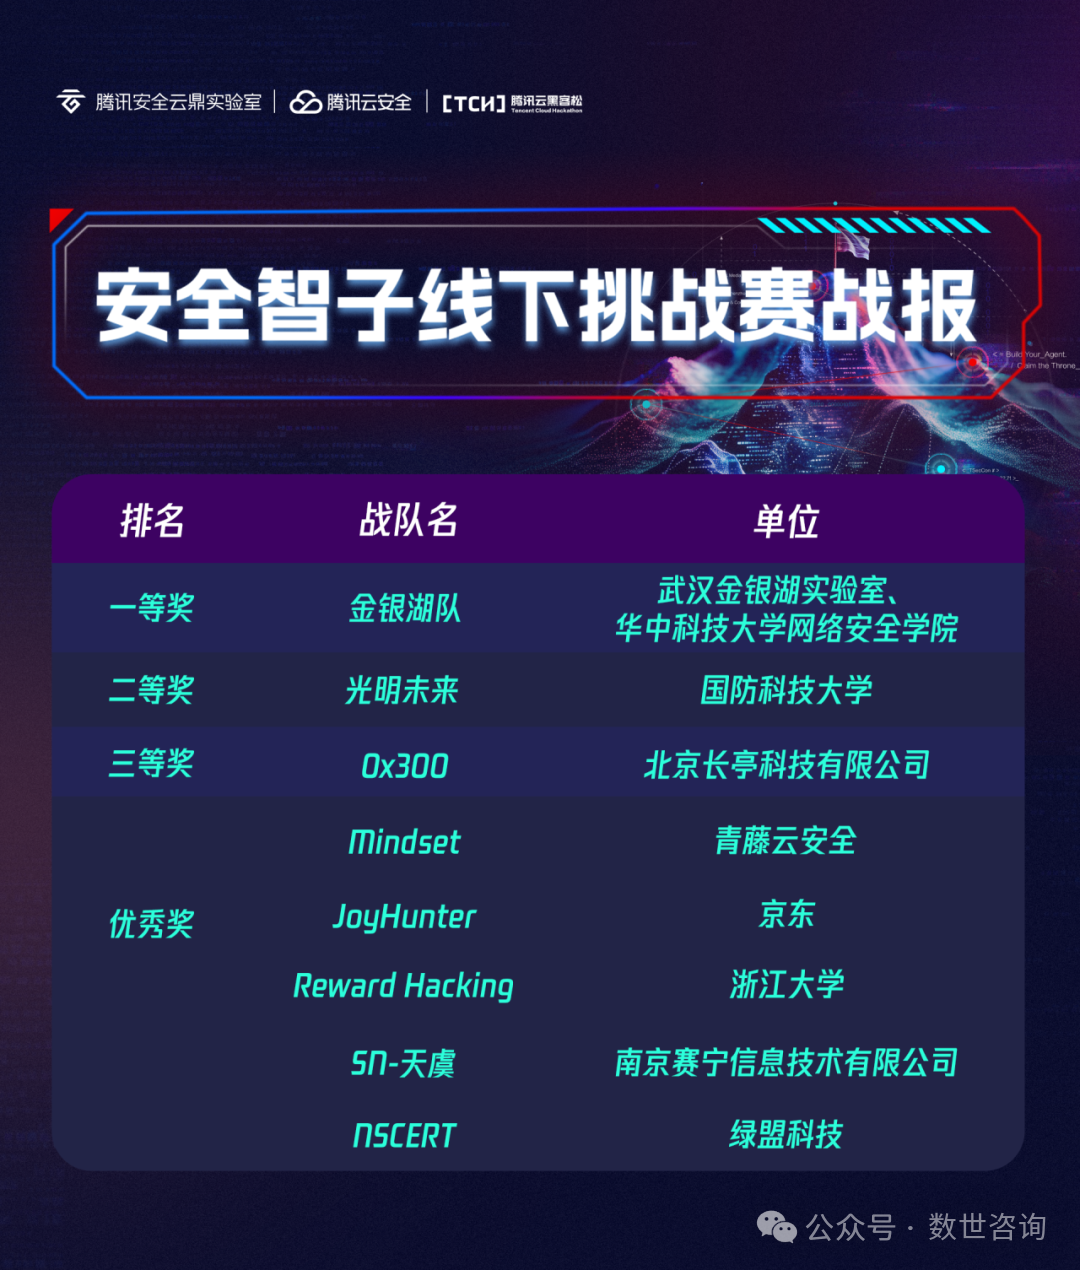
安全智子专项挑战赛最终排名
跨过“分水岭”:从渗透测试到漏洞挖掘,AI能力开始爆发
颁奖环节最后,腾讯云副总裁董志强作总结致辞。
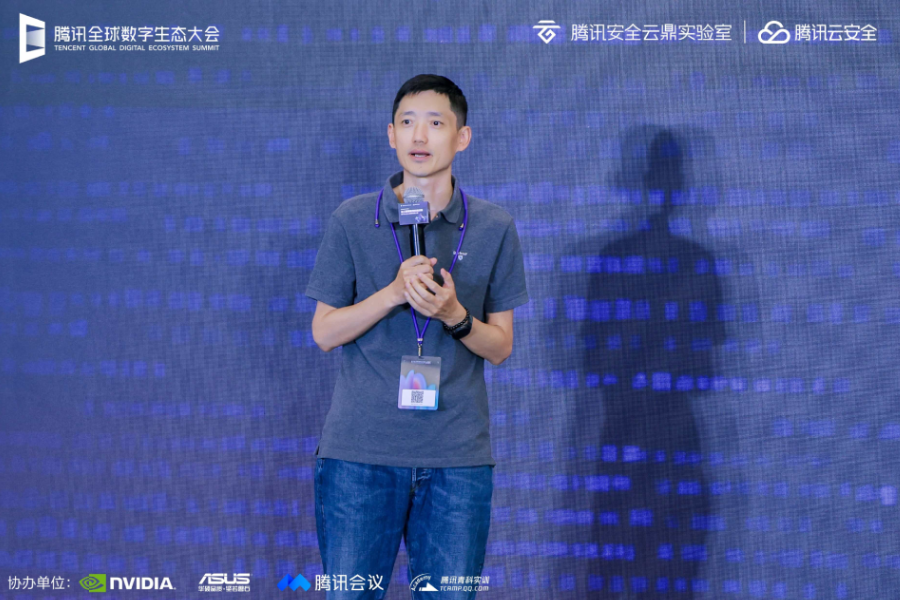
他指出“今年以来,大模型能力已经“过了一个分水岭”。越过这个节点之后,AI在渗透测试上的能力开始爆发,随后漏洞挖掘能力也快速显现,比赛的最终意义是“以攻促防”。
本届赛事中,主办方专门鼓励参赛者使用AI Agent发现腾讯云真实漏洞,并将相关流量统一接入流量网关进行核验,让能力验证始终处于授权和可控范围内。
从“智能渗透”到“智能攻防”,第三届赛事呈现出的变化已经不只是赛题变难,而是AI攻击能力开始从能力验证走向工程化和实战化。
过去反复追问的是“AI能不能做”?接下来更现实的问题,或许是——当AI真的能够做到,我们怎样把它用好。
热门文章

调研报告
-
报告发布 |《全球数据泄露态势月度报告》(2026年9月)
-
报告发布 | 数据安全分类分级调研报告
-
报告发布 |《全球数据泄露态势月度报告》(2026年8月)| 附下载地址
-
报告发布 | 大模型安全测评体系与实践报告(2026)
-

价值图谱 | WEB漏洞扫描产品核心能力介绍