医疗专业模型如何交出通用模型约4~5倍的识别成绩?
医院开展数据治理工作,往往要从晦涩的数据库表名、字段编码入手。一串串字符背后,承载着患者身份标识、诊疗记录、业务运行参数等关键信息。只有读懂字段背后真实业务含义,才能精准判定数据类别,落实对应的安全保护要求。
但在真实业务场景中,大量医疗数据库存在字段缩写表意模糊、中文注释缺失等现实痛点。针对这一行业难题,霍因科技推出人马座医疗专业大模型,该模型基于Qwen3‑8B底座,结合海量医疗行业真实业务数据完成专项训练与微调。在总计约8.4万道内部评测试题中,模型字段识别完全匹配率可达85.6%,性能约为通用对照模型的4.8倍。
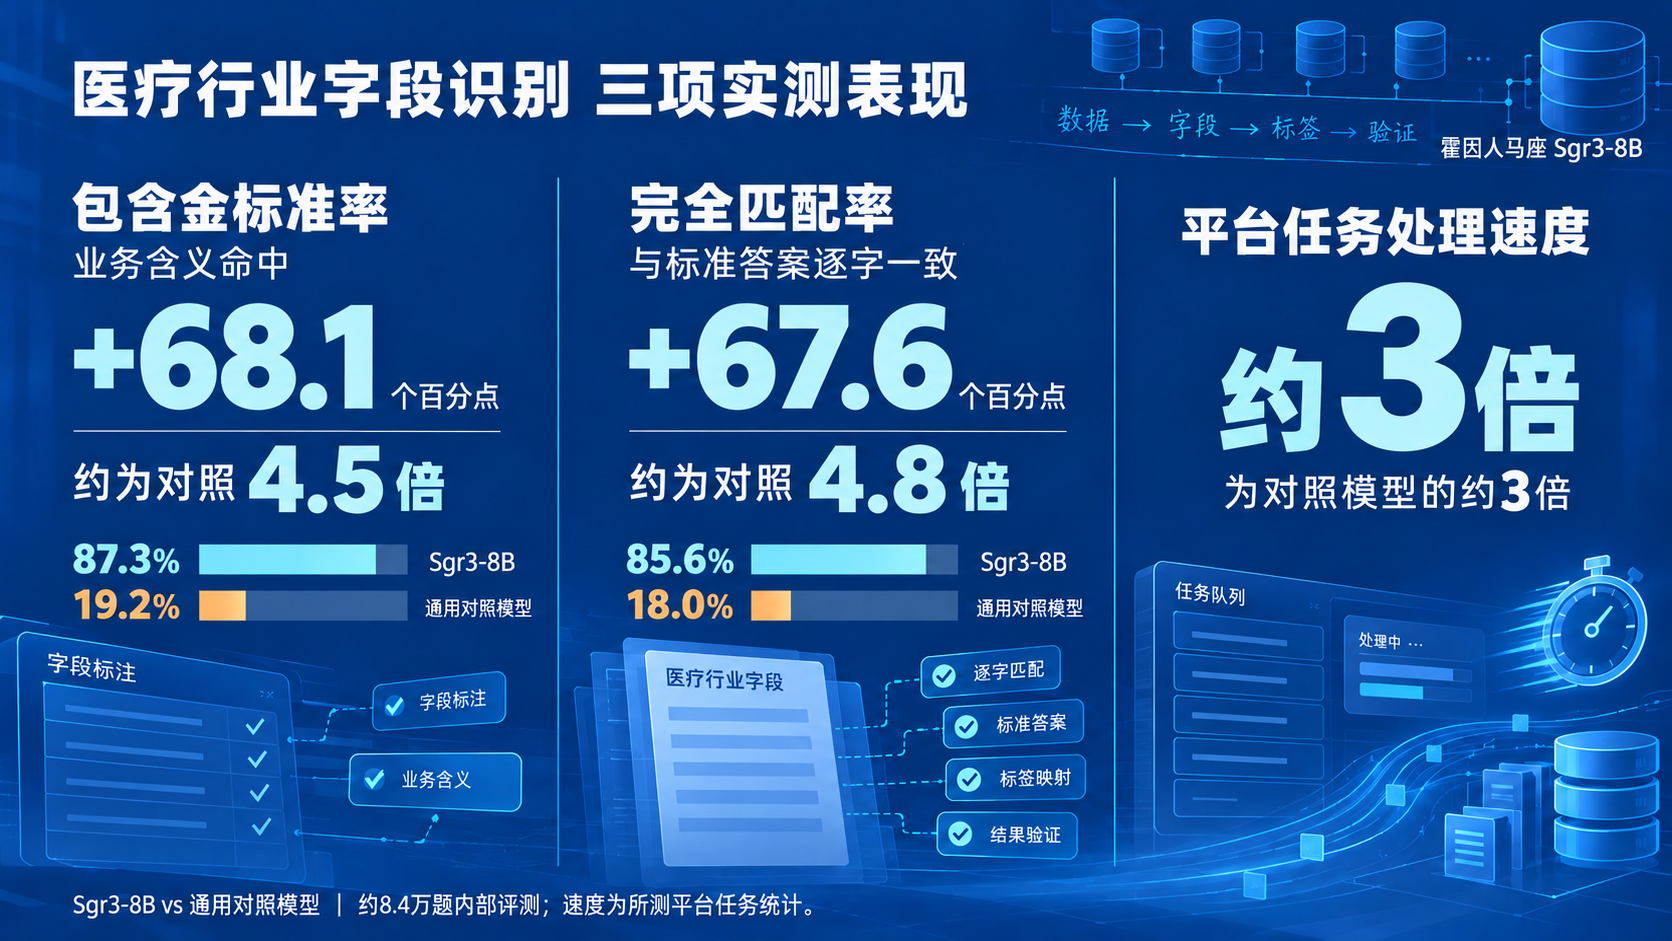
图1 两项字段识别指标的差值与平台任务处理速度
一、工具在进步,医疗行业字段语义仍需补齐
医疗行业的数据识别工作,已经具备相应的政策标准与技术工具基础。国家卫生健康委早在 2020年就发布相关指导意见,也指出医疗数据标准落地过程中,存在标准应用不协同、不统一等现实问题。[1]技术层面,行业普遍依靠业务词典、元数据、正则规则完成字段识别,不少产品也逐步引入大模型能力提升识别效果。[2]
可落到医院存量数据库表治理工作中,依旧绕不开复杂的业务语境难题。很多缺少注释的字段缩写往往具备多重释义,同一个字段编码,放置在不同业务数据表内,代表的业务含义也截然不同。传统规则、词典方案高度依赖完备的字段定义与特征库;一旦原始字段说明缺失,工作人员只能翻阅历史文档、梳理表结构,反复对接业务人员确认含义,耗费大量人力成本。
二、从医疗行业库表出发,让标签贴近业务
人马座大模型的研发针对这项基础工作展开。霍因围绕医疗行业库表结构、缩写编码和标注规范进行训练与微调,使模型结合表名与相关字段信息,生成中文业务标签。
例如在真实库表语境下,模型能够将 “HDDQ” 识别为 “活动地区”,将 “DJRYDM” 识别为 “登记人员代码”。原本晦涩的编码转化为可读的业务释义,为后续数据治理规则落地打下基础,当然具体释义仍需要结合数据表结构做二次校验。
整表梳理时,模型可一次处理多个字段;中文注释缺失时,可用于备注补全。输出按指定格式组织,方便平台接收。信息不足时可返回“未知”,留待补充上下文。这些能力适用于存量库表首轮标注和新增字段梳理。
三、约8.4万题评测,观察识别效果与任务适配
图2对照完全匹配率、包含金标准率和格式正确率。前两项分别考察与标准答案逐字一致、包含标准业务含义;格式正确率衡量是否按约定输出。
评测结果显示,人马座大模型完全匹配率达85.6%,相较通用对照模型的18.0% 提升 67.6 个百分点;包含金标准率87.3%,对比对照组19.2% 提升 68.1 个百分点,性能约为通用模型的 4.5 倍;格式正确率高达99.6%,保障输出结果可以被治理平台稳定解析调用。

图2 医疗行业字段标签识别三项指标对照
图3进一步区分四类任务。在约6300道题、7.2万个字段的多字段场景中,题内全部字段正确才计为完全匹配,人马座大模型得分85.8%,对照15.6%。单字段、格式变换同样列出对照结果;信息不足场景两模型成绩接近,用于观察存疑字段的处理表现。
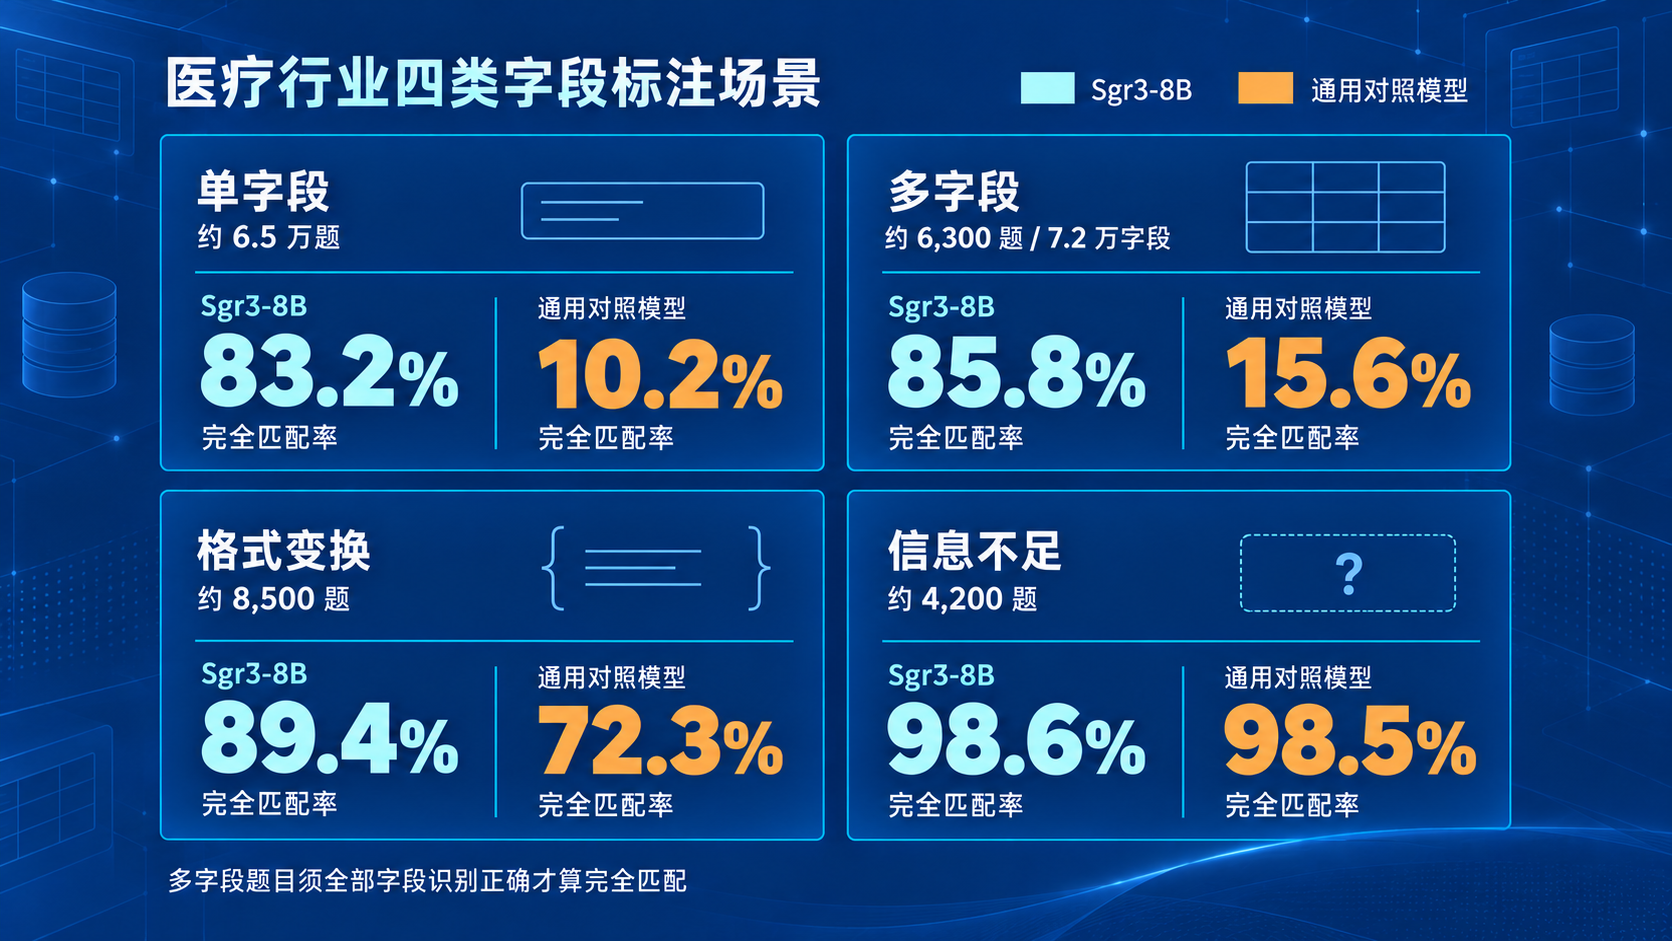
图3 四类字段标注任务的完全匹配率与样本规模
四、HIS真实数据评测,分别检验两项业务任务
围绕某南方医院HIS系统真实数据,霍因开展备注补全与字段标签识别评测。两项任务各自列示训练、验证和测试结果,应用表现重点看测试集。
图4对应备注补全,即为数据库字段补齐中文说明。测试集完全匹配率为85.3%,对照5.2%,提高80.1个百分点;包含金标准率为86.9%,对照8.4%。两项指标共同观察备注是否符合标准答案及业务含义。

图4 HIS真实数据备注补全评测 训练验证测试结果分列
图5对应字段标签识别,以横向柱状图比较两模型表现。测试集完全匹配率85.1%,对照11.7%,提高73.4个百分点;包含金标准率86.2%,对照12.4%。与备注补全分开展示,便于判断两类任务的适配情况。
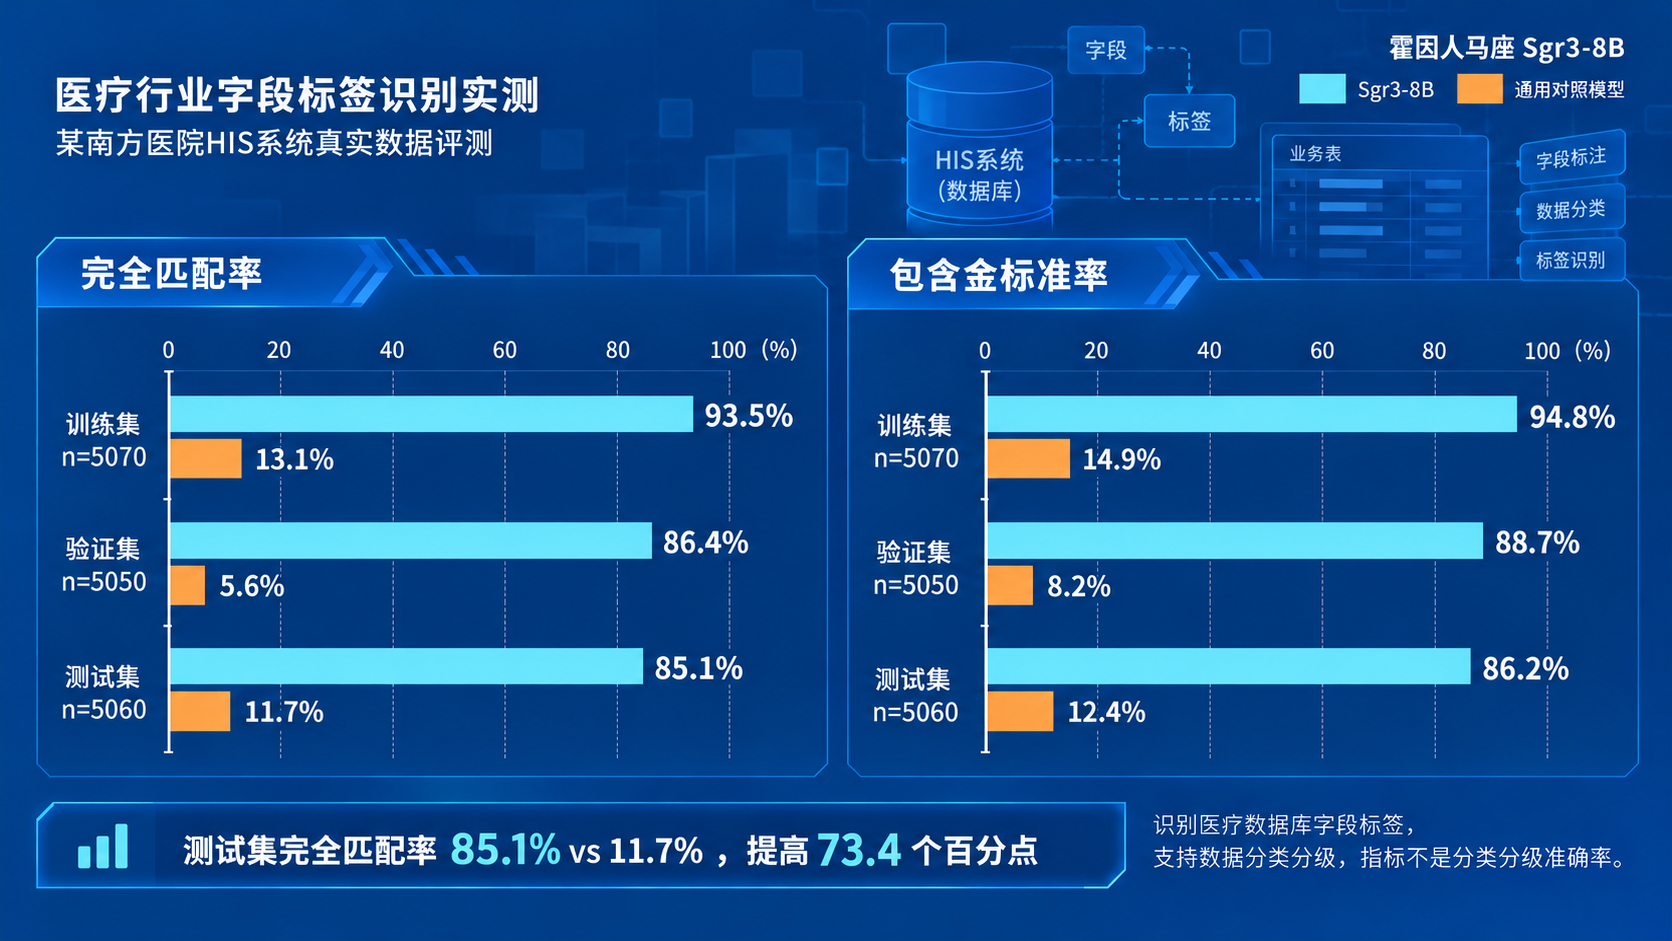
图5 HIS真实数据字段标签识别评测 两项指标横向对照
按现有平台任务统计,人马座大模型处理速度约为通用对照模型的3倍,为批量库表梳理提供效率参考。
五、让字段含义成为分类分级的依据
人马座大模型支持私有化部署,可在客户内网通过服务接口接入治理平台。标签或备注经业务字典及人员复核后,进入数据目录,再结合既有规则确定类别与等级。
面对历史存量库表,模型可以批量生成待复核的字段标签,大幅缩减人工标注工作量;面向业务持续迭代产生的新增字段,也能够提供可反复调用的常态化识别能力。如果医疗机构有字段识别、备注补全、平台对接相关需求,可联系霍因科技,沟通适配的测试与私有化部署方案。
段落参考文献:
[1] 国家卫生健康委 关于加强全民健康信息标准化体系建设的意见 2020年
热门文章
调研报告
-
【梆梆安全监测】安全隐私合规监管趋势及漏洞风险报告(0921-1004)
-
报告发布 | 数据安全分类分级调研报告
-
报告发布 |《全球数据泄露态势月度报告》(2026年8月)| 附下载地址
-
报告发布 | 大模型安全测评体系与实践报告(2026)
-

价值图谱 | WEB漏洞扫描产品核心能力介绍